Segmentación de memoria - Hacking: The Art Of Exploitation
Aviso legal
Pese a que la información que se muestra en esta publicación es meramente educativa, el uso inapropiado/malicioso de técnicas de corrupción de memoria que se puedan ejecutar con estos conocimientos queda prohibida bajo ciertos contextos legales y dicha actividad puede llegar a estar penada. Quedas avisado.
Bienvenidos mis queridos hackers a esta publicación donde aprenderéis acerca de la memoria de un programa y cómo funciona. La inspiración para poder realizar esta publicación fue debido a que he comenzado a leer "Hacking: The Art Of Exploitation" y existe un capítulo en el libro dedicado a la segmentación de memoria, cómo funciona, y cómo se componen los programas cuando se trata de la memoria. Aclarar que si bien el libro es muy antigüo y fue escrito para arquitecturas de tipo x86 (véase "Apuntes de lenguaje ensamblador"), es posible aprender mucho a día de hoy.
Segmentación de memoria
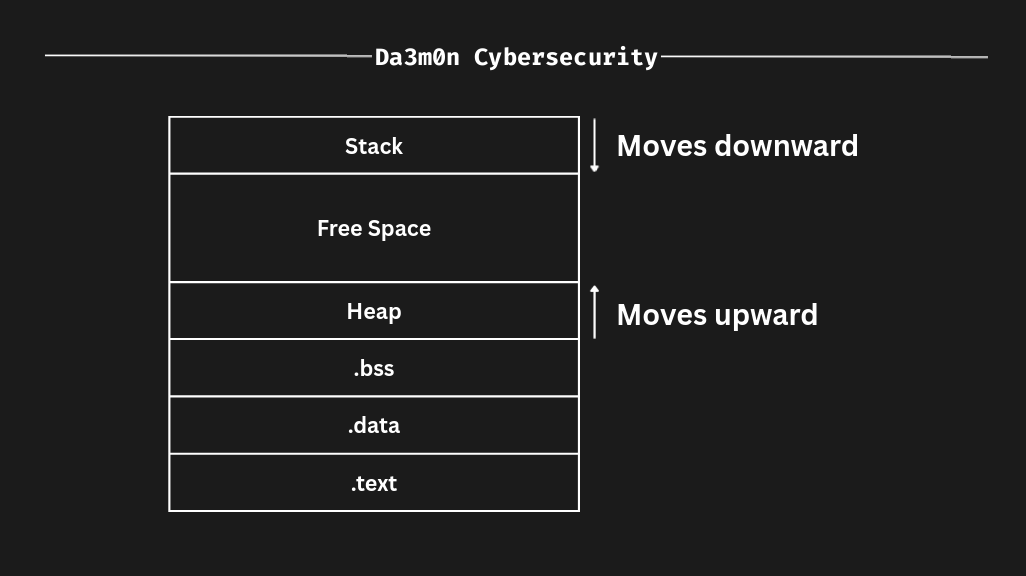
Citando al propio libro, "la memoria de un programa compilado es dividida en 5 segmentos". Los segmentos que encontramos son los siguientes:
text
Segmento de código. Es donde se encuentran las instrucciones ensambladas en código máquina (binario). Se trata de un segmento de sólo lectura, es decir, no se puede cambiar el contenido en memoria de este segmento.
data
Se hallan en él las variables inicializadas (variables a las cuales se les asigna un valor en su misma creación) globales y estáticas del programa. Se trata de un segmento de lectura/escritura, es decir, se puede cambiar el contenido en memoria de este segmento (pero los tamaños para las variables se mantienen fijos).
#include <stdio.h>

int main() {
  char message[10] = "Hello";

  printf("%s\n", message);

  return 0;
}
La variable "message" es una variable inicializada porque se le ha asignado un valor en la propia creación de la misma. Si se quisiera reescribir en memoria la variable "message", solo se podrían escribir los 10 bytes que tiene asignados, ni más, ni menos.
bss
Se hallan en él las variables que no han sido inicializadas. Se trata de un segmento de lectura/escritura, es decir, se puede cambiar el contenido en memoria de este segmento (pero los tamaños para las variables se mantienen fijos).
#include <stdio.h>
#include <string.h>

int main() {
  char message[10];

  strcpy(message, "Hello");

  printf("%s\n", message);

  return 0;
}
Al contrario que en ejemplo anterior, "message" es una variable que no ha sido inicializada por que no se le ha asignado un valor en su creación, sino después de esta. Al igual que pasa con la sección "data", el tamaño en la sección de memoria se mantiene fijo, por lo que no se puede escribir más de 10 bytes en esta variable.
heap
Este segmento de memoria es uno que el programador puede controlar directamente. Los bloques de memoria de este segmento pueden ser asignados y usados para lo que sea que el programador necesite. Se trata de un segmento de lectura/escritura, es decir, se puede cambiar el contenido en memoria del segmento. Además. el segmento no posee tamaño fijo, por lo que puede crecer y decrecer a voluntad, al contrario de los otros segmentos que poseen un tamaño fijo. El heap crece y decrece gracias a algoritmos de asignación y desasignación, que permiten reutilizar memoria no reservada en los otros segmentos. Esto se realiza en la propia ejecución del programa. El crecimiento del heap se usa para alcanzar regiones de memoria cada vez mayores dentro de la pila de memoria (el conjunto de segmentos).
stack
El stack es, tal y como se mostró en la imagen anterior y al igual que con el heap, es un segmento con tamaño variable, que puede usarse como espacio de almacenamiento temporal para guardar, por ejemplo, variables locales. Esto es lo que revisa el comando backtrace en GDB (GNU Debugger). Cuando se llama a una función, el stack se utiliza para almacenar el conjunto de variables que se han pasado de una función a otra cambiando el contexto.
#include <stdio.h>

int print_output(char *variable) {
  printf("%s\n", variable);

  return 0;
}

int main() {
  char message[] = "Hello";

  print_output(message);

  return 0;
}
En este ejemplo, cuando el contexto de la variable "message" cambia a la variable "variable" en la función print_output, la variable que contiene el valor "Hello" se almacena dentro del segmento del stack.
El stack no solo almacena las variables que cambian de contexto (variables que se pasan entre funciones), también almacena información sobre la posición del puntero de instrucción (rip) antes de acceder a la nueva función. Aprovechando el código anterior, si el rip se encontraba en la línea print_output(message);, cuando se ejecute la siguiente instrucción, el puntero de instrucción saltará a la línea printf("%s\n", variable);, y seguidamente, ejecutará la función poniendo por pantalla Hello. Para poder volver a la función main, debe almacenar en memoria la dirección de memoria que va después de print_output(message);, la cual le llevaría al puntero de instrucción al return 0, finalizando la ejecución del programa. La dirección de retorno después de terminar la ejecución de una función es lo que se almacena en el stack junto con variables que cambian de contexto. Además de esto, el stack también almacena las nuevas variables locales de la función hacia la que se salta. Toda esta información se almacena en lo que se suele llamar un stack frame, y en el stack, existen muchos stack frames.
Como ya se vió en "Apuntes de lenguaje ensamblador", el stack es una estructura de datos abstracta, es decir, que se puede interpretar de muchas maneras. Aun así, en todas las maneras de las que se pueda interpretar, el stack sigue el principio "LIFO" (Last-in, first-out), que indica que el último dato en ser insertado dentro del stack, será el primero en salir del mismo. Cuando queremos insertar información dentro del "stack", lo que hacemos es algo conocido como "pushing", y cuando queremos sacar información, lo que hacemos es algo conocido como "popping".
Tal y como el nombre indica, el segmento de memoria del stack se refiere a la propia estructura de datos del "stack". que contiene muchos stack frames. El registro de puntero del stack (rsp) se utiliza para llevar monitorizar dónde acaba el stack, ya que la dirección de memoria donde finaliza el stack está en constante movimiento debido a que el tamaño del stack varía debido a la introducción y expulsión de datos dentro del stack. Debido a que es una labor muy dinámica, se entiende el por qué el stack no posee un tamaño fijo, ya que nunca se sabrá si se necesitará un tamaño mayor o menor para almacenar la cantidad de datos que requiera. Al contrario que el stack, tal y como se ha representado anteriormente en una imágen, el stack decrece hacia direcciones de memoria menores, acercándose cada vez más al heap.
Cada vez que llamamos a un función, se carga la información necesaria un nuevo stack frame (nuevas variables locales, la dirección de retorno del rip, y variables que son pasadas entre funciones). El registro rbp, también llamado a veces "frame pointer" (FP), o "local base" (BP), es usado como referencia para las variables de la función local. Cada "stack frame" contiene los parámetros para las funciones, sus variables locales, y dos punteros que son necesarios para poner las cosas de vuelta donde estaban antes de crear el nuevo "stack frame" (es decir, antes de llamar a la función). El SFP (saved frame pointer) se usa para restaurar rbp a su valor previo, y el "return address" para restaurar el rip a la siguiente instrucción después de la llamada a la función (tal y como mencionamos anteriormente). Esto restaura el contexto funcional del "stack frame" previo.
Para practicar, el siguiente código de ejemplo stack_example.c posee dos funciones: main y test_function:
#include <stdio.h>

void test_function(int a, int b, int c, int d) {
  int flag;
  char buffer[10];

  flag = 31337;
  buffer[0] = 'A';
}

int main() {
  test_function(1, 2, 3, 4);
}
Cuando desensamblamos el binario en instrucciones en ensamblador, podemos observar estas instrucciones que corresponden al código dentro de la función main:
pwndbg> disas main
Dump of assembler code for function main:
   0x0000000000001147 <+0>:	push   rbp
   0x0000000000001148 <+1>:	mov    rbp,rsp
   0x000000000000114b <+4>:	mov    ecx,0x4
   0x0000000000001150 <+9>:	mov    edx,0x3
   0x0000000000001155 <+14>:	mov    esi,0x2
   0x000000000000115a <+19>:	mov    edi,0x1
   0x000000000000115f <+24>:	call   0x1129 <test_function>
   0x0000000000001164 <+29>:	mov    eax,0x0
   0x0000000000001169 <+34>:	pop    rbp
   0x000000000000116a <+35>:	ret
End of assembler dump.
pwndbg>
Las instrucciones que componen las líneas main <+0> y main <+1> son las llamadas "procedure prologue" o "function prologue" (prólogo de instrucción/prólogo de función). Se encargan de almacenar el frame pointer en el stack frame, y dependiendo del compilador y las opciones de compilación, pueden llegar incluso a alinear el stack. Como podemos ver, estas instrucciones se reflejan también en la función test_function, donde al comanzar un nuevo stack frame, se vuelve a almacenar el frame pointer.
pwndbg> disas test_function
Dump of assembler code for function test_function:
   0x0000000000001129 <+0>:	push   rbp                         <---
   0x000000000000112a <+1>:	mov    rbp,rsp                     <---
   0x000000000000112d <+4>:	mov    DWORD PTR [rbp-0x14],edi
   0x0000000000001130 <+7>:	mov    DWORD PTR [rbp-0x18],esi
   0x0000000000001133 <+10>:	mov    DWORD PTR [rbp-0x1c],edx
   0x0000000000001136 <+13>:	mov    DWORD PTR [rbp-0x20],ecx
   0x0000000000001139 <+16>:	mov    DWORD PTR [rbp-0x4],0x7a69
   0x0000000000001140 <+23>:	mov    BYTE PTR [rbp-0xe],0x41
   0x0000000000001144 <+27>:	nop
   0x0000000000001145 <+28>:	pop    rbp
   0x0000000000001146 <+29>:	ret
End of assembler dump.
pwndbg>
Además, (esto tiene poco que ver con la segmentación, pero me ha parecido interesante recalcarlo) podemos ver cómo se asignan a cada una de las variables "a", "b", "c" y "d" los números "1", "2", "3" y "4" respectivamente.
pwndbg> disas test_function
Dump of assembler code for function test_function:
   0x0000000000001129 <+0>:	push   rbp
   0x000000000000112a <+1>:	mov    rbp,rsp
   0x000000000000112d <+4>:	mov    DWORD PTR [rbp-0x14],edi     <---
   0x0000000000001130 <+7>:	mov    DWORD PTR [rbp-0x18],esi     <---
   0x0000000000001133 <+10>:	mov    DWORD PTR [rbp-0x1c],edx     <---
   0x0000000000001136 <+13>:	mov    DWORD PTR [rbp-0x20],ecx     <---
   0x0000000000001139 <+16>:	mov    DWORD PTR [rbp-0x4],0x7a69
   0x0000000000001140 <+23>:	mov    BYTE PTR [rbp-0xe],0x41
   0x0000000000001144 <+27>:	nop
   0x0000000000001145 <+28>:	pop    rbp
   0x0000000000001146 <+29>:	ret
End of assembler dump.
pwndbg>
Podemos comprobarlo examinando el contenido de los punteros que se muestran en las líneas anteriores (rbp-0x14, rbp-0x18, rbp-0x1c y rbp-0x20).
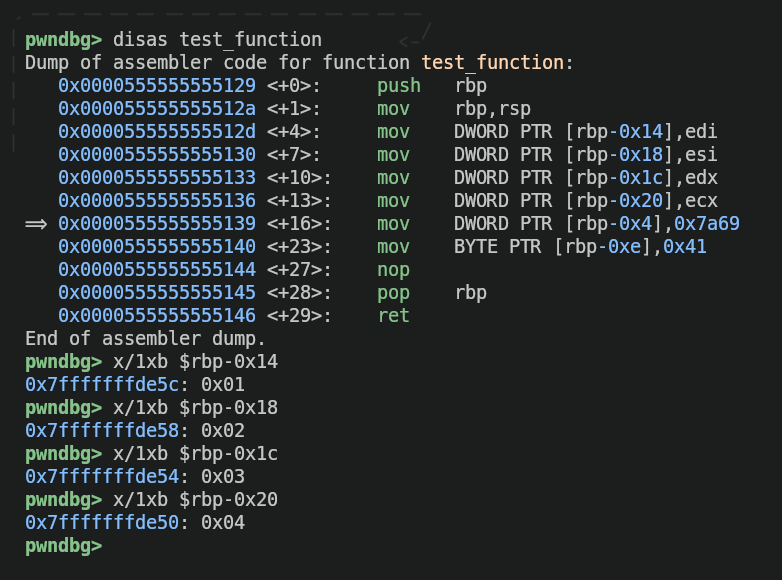
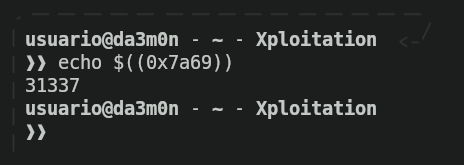
La siguiente línea (0x0000555555555139) contiene la flag "31337", solo que codificada en formato binario como se puede ver a continuación.
Volviendo a la función "main", concretamente a la línea 0x000055555555515f.
pwndbg> disas main
Dump of assembler code for function main:
   0x0000555555555147 <+0>:	push   rbp
   0x0000555555555148 <+1>:	mov    rbp,rsp
   0x000055555555514b <+4>:	mov    ecx,0x4
   0x0000555555555150 <+9>:	mov    edx,0x3
   0x0000555555555155 <+14>:	mov    esi,0x2
   0x000055555555515a <+19>:	mov    edi,0x1
   0x000055555555515f <+24>:	call   0x555555555129 <test_function>    <---
   0x0000555555555164 <+29>:	mov    eax,0x0
   0x0000555555555169 <+34>:	pop    rbp
   0x000055555555516a <+35>:	ret
End of assembler dump.
pwndbg>
En el siguiente paso, el valor actual de "rbp" se almacena en el stack (debido a la naturaleza de la instrucción "call"). Este valor es conocido como "saved frame pointer" (SPF, del que ya hablamos anteriormente), y es el qye se usará para restaurar "rbp" a su valor original una vez finalizada la función test_function.
Ahora, podemos ver cómo se construye el stack desde 0 gracias a GDB de forma más práctica. Para ello, usaré un trozo de código escrito en el libro "Hacking: The Art Of Exploitation" para demostrarlo (hice algunos cambios, sin embargo, el comportamiento es el mismo).
#include <stdio.h>
#include <stdlib.h>

int global_var;
int global_initialized_var = 5;

void function() {	// This is just a demo function
	int stack_var;	// Notice this variable has the same name as the one in main().

	printf("the function's stack_var is at address %p\n", &stack_var);
}

int main() {
	int stack_var;	// Same name as the variable in function()
	static int static_initialized_var = 5;
	static int static_var;
	int *heap_var_ptr;

	heap_var_ptr = (int *) malloc(4);

	// These variables are in the data segment
	printf("global_initialized_var is at address %p\n", &global_initialized_var);
	printf("static_initialized_var is at address %p\n\n", &static_initialized_var);

	// These variables are in the bss segment
	printf("global_var is at address %p\n", &global_var);
	printf("static_var is at address %p\n\n", &static_var);

	// This variable is in the heap segment
	printf("heap_var is at address %p\n\n", heap_var_ptr);

	// These variables are in the stack segment
	printf("stack_var is at address %p\n", &stack_var);
	function();

	return 0;
}
memory_segmentation.c
Abriré GDB para comprobar las direcciones de memoria donde se guarda la información. Para ello, pondré breakpoints en el final de la función function para evitar que el programa finalice la ejecución.
pwndbg> disas function
Dump of assembler code for function function:
   0x0000555555555149 <+0>:	push   rbp
   0x000055555555514a <+1>:	mov    rbp,rsp
   0x000055555555514d <+4>:	sub    rsp,0x10
   0x0000555555555151 <+8>:	lea    rax,[rbp-0x4]
   0x0000555555555155 <+12>:	mov    rsi,rax
   0x0000555555555158 <+15>:	lea    rax,[rip+0xea9]        # 0x555555556008
   0x000055555555515f <+22>:	mov    rdi,rax
   0x0000555555555162 <+25>:	mov    eax,0x0
   0x0000555555555167 <+30>:	call   0x555555555030 <printf@plt>
   0x000055555555516c <+35>:	nop
   0x000055555555516d <+36>:	leave
   0x000055555555516e <+37>:	ret
End of assembler dump.
pwndbg> break *0x000055555555516c
Breakpoint 1 at 0x55555555516c: file memory_segmentation.c, line 11.
pwndbg>
Y al ejecutar la aplicación, nos aparece lo siguiente.
pwndbg> run
Starting program: /home/usuario/daemon/knowledge/c/code/memory_segmentation
[Thread debugging using libthread_db enabled]
Using host libthread_db library "/lib/x86_64-linux-gnu/libthread_db.so.1".
global_initialized_var is at address 0x555555558020
static_initialized_var is at address 0x555555558024

global_var is at address 0x55555555802c
static_var is at address 0x555555558030

heap_var is at address 0x5555555592a0

stack_var is at address 0x7fffffffde14
the function's stack_var is at address 0x7fffffffddfc

Breakpoint 1, function () at memory_segmentation.c:11
11	}
LEGEND: STACK | HEAP | CODE | DATA | WX | RODATA
Como podemos ver, las variables son inicializadas en el segmento data son las que se guardan en las direcciones más bajas de la memoria RAM, las variables sin inicializar en el segmento bss se almacenan en unas direcciones con números más altos que en la sección data, pero menor que heap. La sección heap se almacena en una dirección con un número mucho mayor que las anteriores, y el stack, como se puede comprobar, se almacena en una dirección muy superior que las demás.
pwndbg> x/w 0x555555558020
0x555555558020 <global_initialized_var>:	0x00000005
pwndbg> x/w 0x55555555802c
0x55555555802c <global_var>:	0x00000000
pwndbg> x/w 0x5555555592a0
0x5555555592a0:	0x00000000
pwndbg> x/w 0x7fffffffde14
0x7fffffffde14:	0x00000000
Referencias